
On this page
Um agente abre um arquivo, vê um loop com aparência estranha e o "simplifica".
O loop era estranho de propósito. Alguém o havia escolhido meses antes, após um incidente, em uma reunião na qual o agente não estava. O PR parece limpo e os testes passam, mas a decisão sumiu.
Este não é um problema novo. Michael Nygard escreveu sobre isso em 2011, quando propôs os Architecture Decision Records. O que mudou foi a frequência com que isso acontece.
Um novo desenvolvedor desfaz uma decisão talvez uma vez, é corrigido e se lembra. Um agente começa cada sessão sem memória de reuniões passadas, revisões ou conversas de corredor. Se uma decisão não estiver escrita, o agente não sabe que ela existe e ficará feliz em "melhorar" o código desfazendo-a.
Escrever as decisões é a solução óbvia, e apenas metade dela. Uma vez que um agente lê seus registros, eles deixam de ser documentação e se tornam instruções. Um registro que ainda é verdadeiro protege a decisão. Um registro que deixou de ser verdadeiro faz o oposto, e o agente não consegue distinguir um do outro.
Isso é prompt injection, exceto que ninguém atacou você. Você mesmo escreveu, meses atrás, e nunca voltou para revisar.
Na Codeminer42, tornamos os ADRs obrigatórios em todos os projetos. Este post é a história de como isso aconteceu em um de nossos projetos de clientes: o que deu errado quando os registros não eram verificados, como um registro nasce, como evitamos que 160 deles consumam o contexto do agente e as verificações que falham no CI quando algo diverge.
Antes: registros que ninguém verificava
O projeto começou a escrever ADRs quase desde o primeiro dia. Os primeiros registros surgiram em maio de 2026. Dois meses depois, havia cerca de 120.
Isso parece um final feliz. Não foi.
- Três números foram repetidos. Backend 0024, backend 0067 e admin portal 0002 apontavam cada um para dois registros diferentes.
- A coluna de status usava sete formulações para quatro relações. "Superseded", "replaced by", "see also", e assim por diante.
- Registros mesclados foram reescritos posteriormente. Um registro de frontend ganhou um parágrafo "Updated 2026-08-28". Cinco registros aceitos haviam sido editados para constar como atuais antes que alguém percebesse. Cada edição escondia quando a decisão mudou e por que.
- Alguns registros diziam uma coisa e o repo fazia outra. Um ADR exigia Conventional Commits. 178 dos últimos 200 commits usaram o prefixo do ticket em vez disso. Outro removeu o Nx, e os monitores de CI do Nx ainda estavam lá.
As decisões existiam, mas nada as verificava.
Com pessoas, isso é um incômodo. Com agentes é pior, porque agentes leem esses registros como instruções. Um agente não consegue distinguir um parágrafo que costumava ser verdade de uma regra em vigor, então um ADR desatualizado o direciona errado e ele segue com total confiança.
Veja o registro de Conventional Commits. Um agente que o lesse antes de fazer o commit escreveria prefixos feat: e fix:, contrariando o que 178 dos últimos 200 commits no projeto fizeram. Ninguém plantou essa instrução. A equipe a deixou lá.
A equipe também notou que agentes abrem um registro diretamente com muito mais frequência do que leem o índice. O que quer que um registro diga por si só, sem contexto, é o que o agente faz.
O que o manifesto diz
Nosso manifesto de IA tem uma seção chamada Usamos práticas compartilhadas. Ela diz:
Decisões arquiteturais fazem parte dessas regras do projeto. Nós as registramos como Architecture Decision Records, para que mineradores e agentes trabalhem a partir das mesmas decisões documentadas em vez de redescobri-las ou desfazê-las silenciosamente.
A outra linha que molda tudo abaixo vem do mesmo documento: IA verifica; humanos atestam. Um agente pode redigir um registro, manter o índice e sinalizar uma contradição. Um humano decide qual é a decisão.
Como nasce um ADR
Quando escrever um
O projeto mantém as explicações fora dos comentários de código (isso é um registro próprio, PL-0010), então o ADR é o único lugar durável onde um motivo pode viver. Isso faz com que a regra de quando escrever um importe muito.
Ela cabe em uma frase, e está na raiz CLAUDE.md:
Escreva um ADR quando uma mudança fizer uma escolha que alguém poderia desfazer sem saber por que ela foi feita.
Qualquer um destes sinais é suficiente:
- você rejeitou uma alternativa que alguém proporá novamente;
- o código parece estranho para o próximo leitor, de propósito;
- códigos futuros terão que seguir uma regra que esta mudança introduz;
- um contrato entre apps mudou.
Todo o resto vai para outro lugar. Uma correção de bug vai no commit. Uma tarefa vai no Jira. Uma convenção que um linter já aplica não vai para lugar nenhum.
Se você se pegar (ou o agente) escrevendo um comentário de código longo explicando o porquê, pare. Esse comentário é um ADR tentando escapar.
A forma
O portal tem quatro stacks: platform, backend, frontend e admin portal. Cada uma mantém seus registros em sua própria pasta docs/adr/, e cada ID carrega o prefixo da stack: PL-0015, BE-0084, FE-0012, AP-0005.
O template é o de Nygard, reduzido:
---
status: accepted
---

# BE-0084: Count pods per organization before committing a transfer

## Context

## Decision

We will <one assertive sentence>.

## Consequences
Algumas regras fazem com que essa forma se mantenha:
- Uma decisão por arquivo. Se o título precisar de um "e", são dois ADRs.
- O título é um imperativo. Ele nomeia a decisão, não o tópico.
- Status e relações vivem no frontmatter, não na prosa. Um registro é
acceptedousuperseded
. Relações (superseded_by, partially_superseded_by, revised_by, extended_by) são declaradas uma vez, no registro mais antigo, e o índice mostra o inverso. 44. Registros mesclados são imutáveis. Trate um ADR como uma migração que já foi executada. Para alterar uma decisão, você escreve um novo registro que substitui o antigo.
As únicas edições permitidas em um registro mesclado são uma relação em seu frontmatter e uma nota de uma linha sob o título: > Superseded by [XX-NNNN](…) on YYYY-MM-DD — one-line reason.
Quem escreve
O agente escreve. Um humano lê e garante que faça sentido.
O agente estava na sessão onde a escolha foi feita. Ele sabe quais alternativas foram tentadas, o que quebrou e o que o código faz agora. Escrever isso é barato para ele.
O que ele não consegue fazer é saber se a decisão está correta. Portanto, o trabalho do humano é ler o registro e verificá-lo em relação ao que foi realmente decidido. Esta é a escolha que fizemos? O contexto é verdadeiro? A próxima pessoa entenderia o porquê, apenas por esta página? Se não, volta para o agente.
A parte burocrática é um comando que o agente executa:
pnpm adr:new backend "Count pods per organization before committing a transfer"Ele pega o próximo número livre, preenche o cabeçalho do template e regenera o índice. Ninguém mais escolhe um número manualmente, que foi como três deles foram usados duas vezes.
A parte difícil não é a burocrática. Um registro que o agente escreve a partir de uma solicitação vaga é um palpite disfarçado de decisão. Portanto, antes de escrever, o agente deve perguntar: o que rejeitamos, quem precisa saber, o que o código futuro deve fazer. A leitura do humano ao final é o que transforma o rascunho em um registro.
Memória: impedindo que os ADRs cresçam para sempre
Quanto mais decisões você registra, melhor fica a memória do agente, até que os registros superem seu contexto e ele pare de lê-los.
O projeto passou de 120 registros para 160. Ninguém cola 160 ADRs em um prompt.
A analogia que mais me ajudou: ADRs são o git log. CLAUDE.mdé a working tree. Você não lê todo o log para saber como o código está hoje. Você lê a working tree, e mergulha no log quando precisa saber o porquê.
O agente funciona da mesma maneira. A raiz CLAUDE.md diz a ele que docs/adr/INDEX.md é "o mapa das decisões em vigor", e que deve começar por ali para encontrar os registros que uma tarefa toca. Então ele lê apenas esses registros, começando pelo frontmatter.
Portanto, o índice é a parte que precisa permanecer pequena e fiel.
Gere o índice, nunca o escreva
Um índice que uma pessoa ou um agente mantém manualmente se desatualiza na primeira semana agitada.
O índice é gerado a partir do frontmatter dos registros. O CI o regenera em cada PR e falha se o commitado for diferente. Se dois PRs conflitam no índice, você não resolve o conflito. Você regenera.
Gaste o contexto do agente no que está em vigor
Então a equipe mediu o índice. Apenas o preenchimento da tabela representava mais da metade do arquivo.
Então o gerador removeu o preenchimento. Depois, removeu completamente os registros substituídos. Eles "custam contexto ao agente e não entregam nada".
Alguém sugeriu movê-los para uma seção ao final. O registro que rejeitou a ideia tem uma frase que eu continuo citando:
Um agente que lê o arquivo ainda assim os lerá.
Hoje o índice lista 156 registros vigentes em cerca de 2.800 palavras. Isso cabe em uma janela de contexto com folga.
Mantenha cada registro pequeno
O CI avisa quando um novo ADR ultrapassa 800 palavras. É um aviso, não uma falha. Um registro tão longo geralmente são duas decisões, ou uma decisão com um diário de implementação anexo. O diário pertence ao PR.
O que não se torna um ADR
A maior parte do que uma equipe aprende nunca se torna um ADR. É um imprevisto, uma gambiarra, algo que uma sessão de agente descobriu e depois perdeu quando a sessão terminou.
Para esse tipo de conhecimento, usamos o ai-memory, um servidor de memória de longo prazo para agentes de codificação. Cada desenvolvedor o executa localmente, e ele captura o que o agente aprende ao longo do caminho: decisões, pegadinhas, procedimentos.
Por si só, essa memória vive em uma máquina. Então, nós a sincronizamos em uma pasta docs/wiki/ no repositório, onde cada desenvolvedor e cada agente podem lê-la. O princípio é o mesmo dos ADRs: se não está no repositório, o próximo agente não sabe.
Deterministic drift checks
O manifesto tem uma frase que eu gosto muito: uma resposta plausível não é evidência. Para ADRs, isso se tornou uma regra simples.
Uma regra que ninguém verifica não se sustenta.
Lembre-se dos cinco registros reescritos. "Não edite ADRs mesclados" era uma frase em um README, e uma frase em um README não faz um build falhar.
Agora, um script faz. É scripts/adr.mjs, cerca de 880 linhas, com 775 linhas de testes. Ele roda em seu próprio workflow em cada PR, em cada push para main, e novamente quando a base de um PR muda. Ele roda até em PRs apenas de documentação, que pulam a CI principal, porque um PR de ADR geralmente é apenas de documentação.
Ele verifica três coisas.
1. The records against each other
O PR falha em caso de:
- um ID duplicado;
- um status incorreto, ou
supersededsemsuperseded_by; - uma relação que aponta para um registro ausente, ou que não está declarada em ambas as direções;
- um cabeçalho que não esteja como
# <ID>: <title>; - um índice que difira do gerado;
- um link quebrado, ou uma pasta de stack que ninguém registrou;
- qualquer edição no corpo de um registro mesclado, ou a exclusão ou renomeação de um.
Este último é o que torna a imutabilidade real. O script compara cada registro com a branch base, então o corpo de um registro mesclado não pode mudar, e um registro substituído não pode voltar a ser vigente.
2. The code against the records
O código cita ADRs em comentários. Nada verifica um comentário em relação ao código abaixo dele, então uma citação pode ficar desatualizada sem aviso.
No nosso projeto, estava pior do que desatualizado. De 289 citações de ADR no código, 225 usavam um número que existia em duas ou mais pilhas. Quando as revisamos, 24 comentários de exceção que se referiam ao registro 3 do backend estavam enviando leitores, e agentes, para o registro 3 da plataforma.
Então, as citações agora usam o ID completo, e o script escaneia cada arquivo .ts, .tsx e .js em apps/ e packages/:
- um número simples (
ADR-0003) ou um caminho falha; - uma citação para um registro substituído avisa: "cite o registro vigente ou remova o comentário."
3. As instruções do agente contra os registros
O mesmo escaneamento é executado em CLAUDE.md, nos arquivos README e em cada skill em .claude/skills/.
Estes são os arquivos que um agente lê primeiro, antes de qualquer registro. Uma referência de ADR morta em uma skill é o tipo mais caro, porque o agente a segue em cada sessão.
O que um script não pode verificar
Nada disso lê o significado de um ADR.
Um script pode dizer que BE-0091 existe, é accepted e está citado corretamente. Ele não pode dizer que um novo worker quebra o que o BE-0091 diz que o worker deve fazer. Ele também não pode verificar o formato do commit, ou se uma variável de ambiente segue o registro que a nomeia.
Isso é revisão. Neste projeto, grande parte da revisão é feita pelo Chicken Little, o agente da equipe, que executa nossa skill de revisão em PRs. Eu o executo e leio o que ele diz antes que qualquer coisa seja postada.
A habilidade de revisão tem uma seção de ADR. Ela orienta o revisor a sinalizar uma escolha feita sem registro, um registro que declare que não houve escolha, e código que contradiga um registro aceito. E diz para ler os registros que cobrem o código que o PR altera, não apenas aqueles que o PR cita. Essa última parte é a que mais importa, porque o PR que quebra uma decisão geralmente não a cita.
Aqui estão três dessas revisões. Em todas elas, os testes passaram e o adr:check estava verde, porque cada registro estava correto. Era o código que havia divergido.
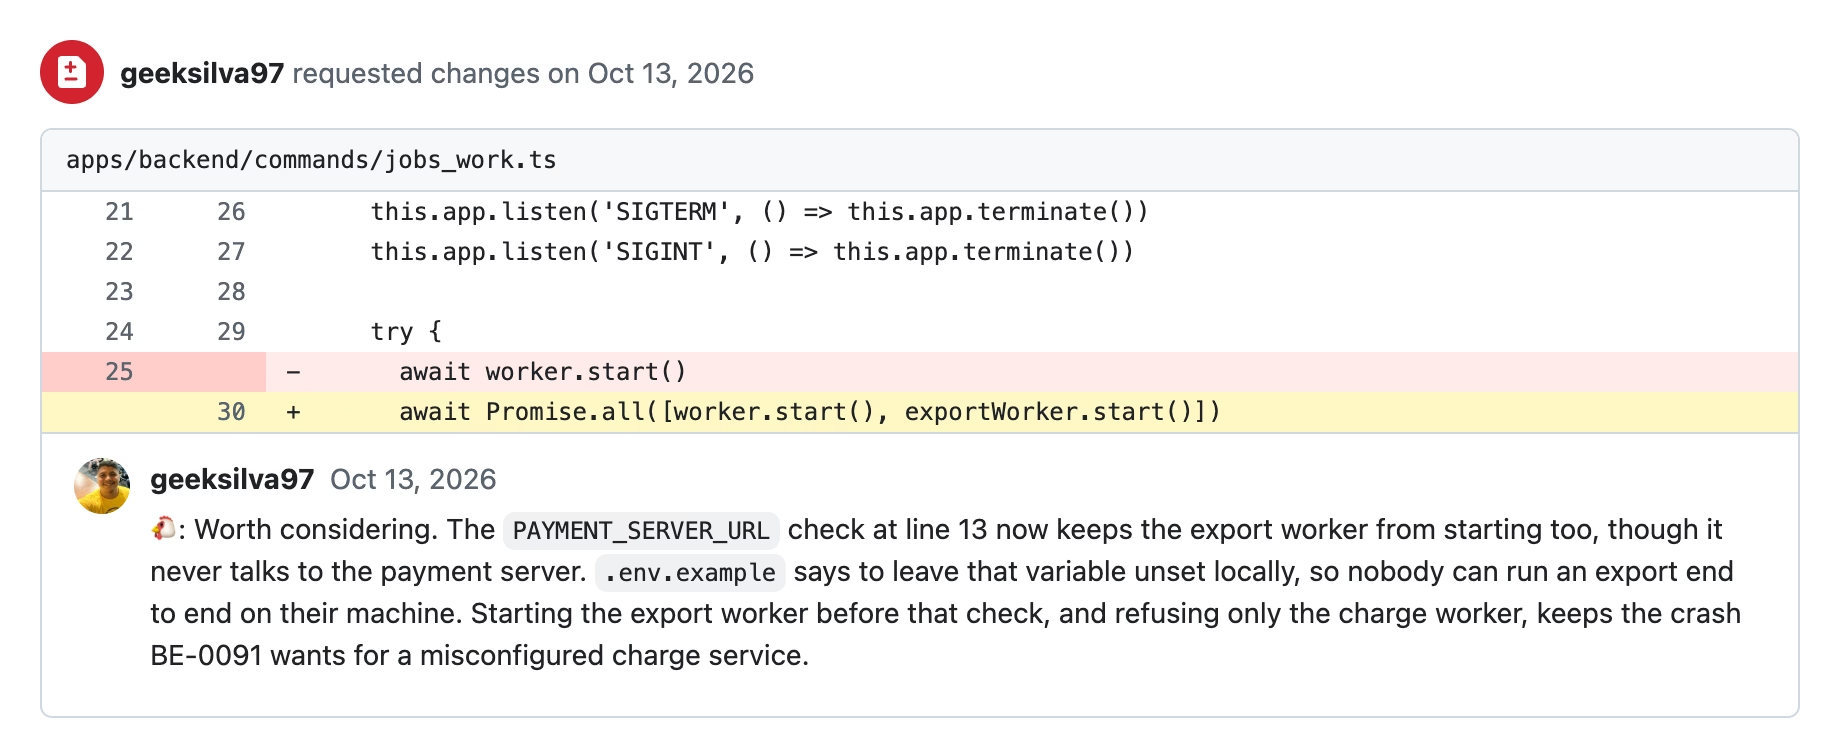
A primeira bloqueou o PR. O BE-0091 quer que o charge worker falhe quando o serviço de pagamento estiver mal configurado. O PR iniciou um segundo worker, para exportações, sob a mesma verificação, então ninguém mais conseguia executar uma exportação em sua máquina.
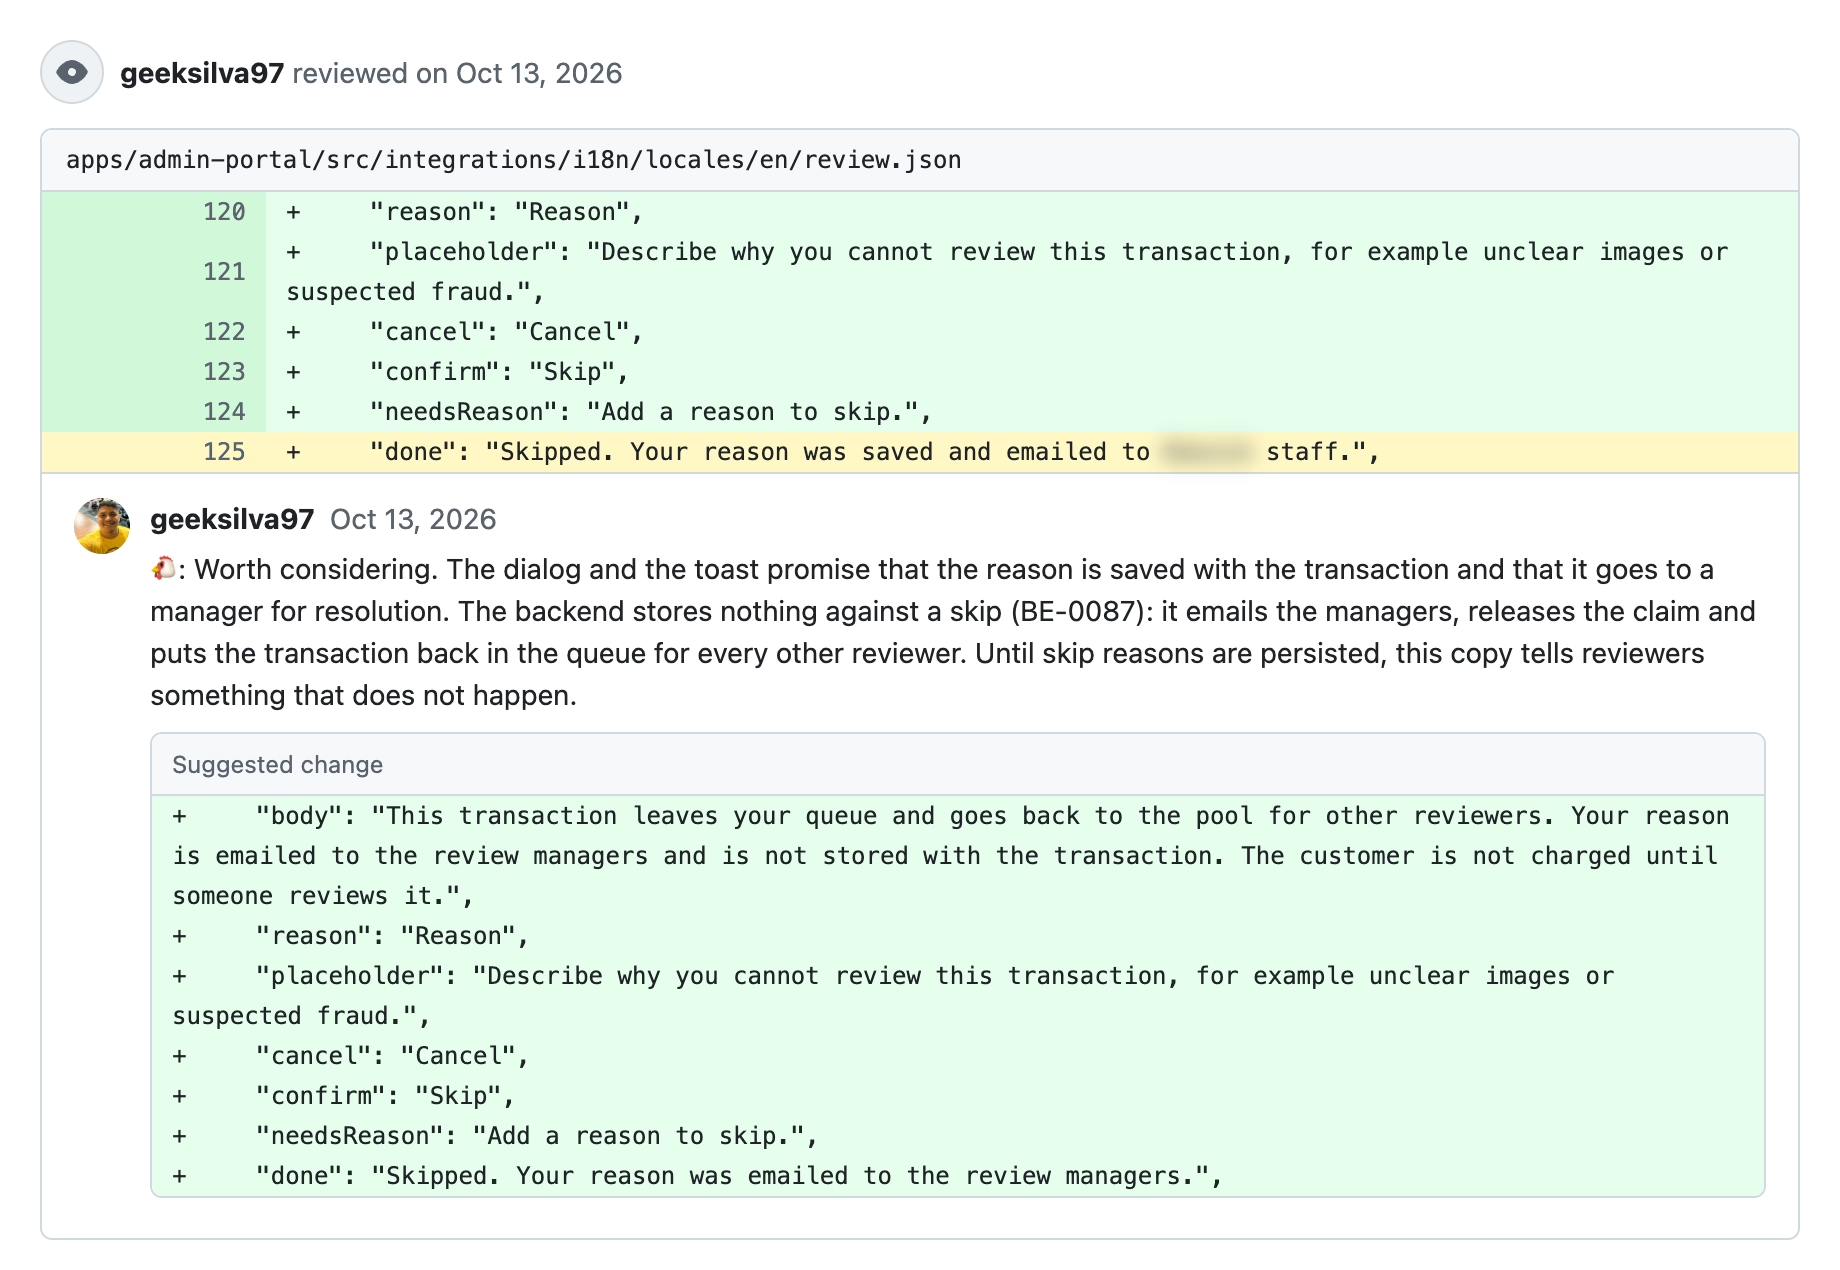
Na segunda, a divergência estava no texto da UI. O diálogo de pular dizia aos revisores que o motivo deles foi salvo com a transação. O BE-0087 diz que o backend não armazena nada: ele envia e-mails para os gerentes e coloca a transação de volta na fila.
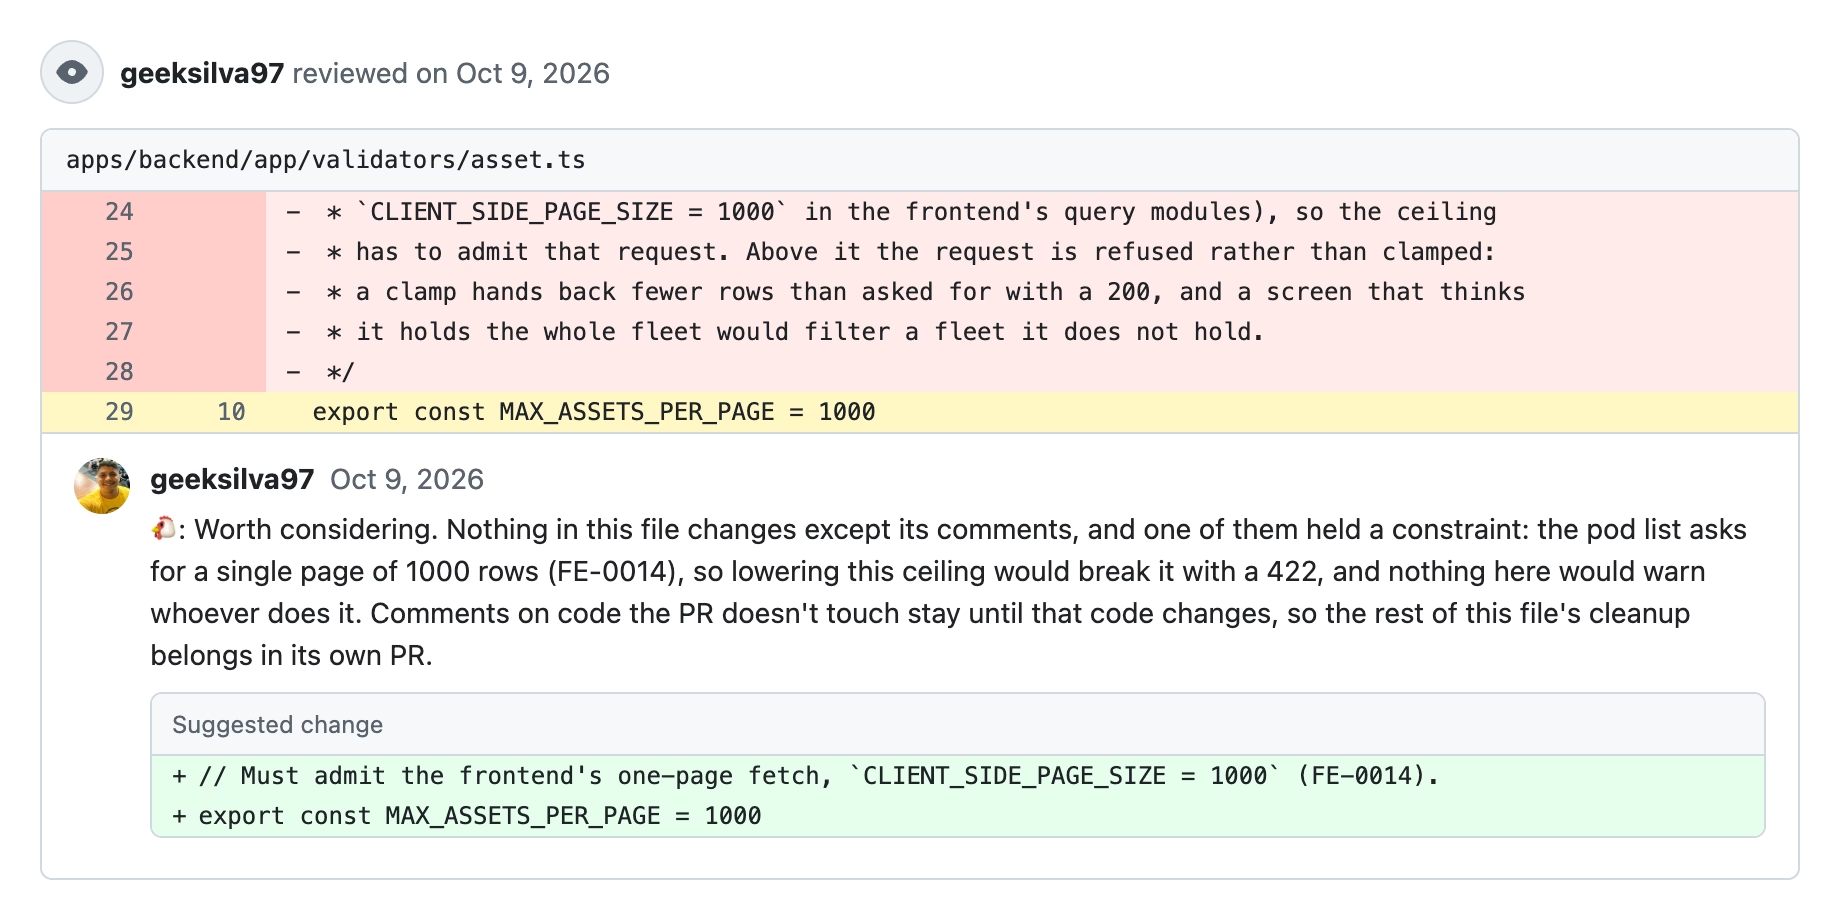
A terceira é a mais discreta. Um PR de limpeza deletou um comentário de código que continha uma restrição do FE-0014: a lista de pods solicita uma página de 1000 linhas, então reduzir esse limite a quebra. A revisão pediu para manter a restrição, citando o registro.
Nos três casos, o revisor encontrou a lacuna ao ler o registro ao lado do código.
A revisão detecta a outra direção também. Em outro PR, uma alteração estendeu o BE-0045, mas não mencionou isso. A revisão solicitou extended_by no frontmatter do registro, e o autor o adicionou no próximo push. A partir daí, o script verifica essa relação.
A ordem importa. As verificações determinísticas vêm primeiro e cobrem tudo o que podem. O agente cobre apenas o que resta: este código faz o que a decisão diz? Nenhum dos dois aprova o PR. Um humano faz isso.
A próxima camada
Há mais um passo que ainda não demos neste projeto: transformar as partes verificáveis de uma decisão em regras de lint.
Algumas decisões são, na verdade, regras de dependência. "O domínio não importa o framework." "O Módulo A não acessa os internos do módulo B." "export * é proibido." Essas não precisam de um LLM para serem verificadas. Elas precisam de ESLint ou dependency-cruiser, com a regra apontando de volta para o registro que a criou.
Se eu estivesse construindo isso, copiaria três ideias:
Uma baseline que apenas diminui. A maioria das bases de código não consegue ir de "decidido" para "zero violações" em um único PR.
Então você registra as violações exatas de hoje. Uma nova falha. Uma corrigida também falha, até que você diminua a baseline, para que a contagem nunca possa crescer silenciosamente de volta.
Um canary para cada regra. É fácil tornar um linter vacuidade.
Um verificador de dependências que percorreu zero módulos sai com 0, e parece exatamente com uma execução limpa. Portanto, cada regra recebe uma violação deliberada que deve detectar.
- Fixe a regra ao registro. Se alguém editar a decisão sem regenerar as regras, o CI deve notar.
Essa é a orientação para as decisões que cabem em uma regra de lint. Para o restante, há a revisão e um humano.
O que eu diria a uma equipe começando hoje
- Escreva o registro quando alguém puder desfazer a escolha sem saber o porquê. Não para cada PR, e não como um changelog.
- Torne os registros imutáveis, e faça o CI impor isso. Substitua; não edite.
- Gere o índice, e descarte o que não está mais em vigor. O contexto do seu agente é um orçamento.
- Verifique as citações, no código e nos arquivos que os agentes leem primeiro.
- Deixe o significado para a revisão, e a decisão final para um humano.
Você não precisa começar de uma pasta vazia. Empacotamos a configuração como uma skill, adr-setup, no repositório Codeminer42 skills:
npx skills add Codeminer42/skills --skill adr-setupEla cria o docs/adr/, o template, um índice e um primeiro ADR registrando a própria adoção. Ela também adiciona uma seção ao seu AGENTS.md ou CLAUDE.md instruindo o agente a ler o índice antes de uma mudança arquitetural, a seguir os registros aceitos e a parar e perguntar quando uma solicitação conflitar com um deles.
Duas coisas que ela não fará. Se o seu repositório já registra decisões de qualquer forma, ela deixa sua prática intacta. E ela não preencherá retroativamente ADRs deduzidos do código: um registro com contexto inventado é pior do que nenhum registro.
O objetivo de um ADR sempre foi evitar que a próxima pessoa desfizesse uma decisão da qual não tinha conhecimento. A próxima pessoa agora, na maioria das vezes, é um agente. Ele lê tudo e não lembra de nada. Tudo o que você quer que ele saiba precisa estar escrito, e tudo o que você escreveu precisa ser revisado, porque ele segue as partes obsoletas também.
Obrigado por ler!
We want to work with you. Check out our Services page!